Практические разборы для инженеров, которые строят приложения с LLM и агентами.
Окно 21–28 сентября 2026Статей 8На заметку 4Просмотрено 229В дайджесте 12
О чём пишут
На этой неделе статьи возвращаются к двум инженерным проблемам: потерянные сведения внутри агента и неизвестный исход внешнего действия. Авторы предлагают проверять trace по отдельным этапам, сохранять ограничения после сжатия контекста и удерживать состояние UNKNOWN после таймаута. Ещё два материала показывают, как ошибка в настройках поиска или лимите вывода искажает оценку системы.
08
Практические статьи
01
Перед передачей трассы агента проверьте итоговый пакет
Трасса агентного запуска может содержать ключи и адреса. Автор проводит её через четыре шага AgentInspect: проверка исходника, редактирование, проверка готового файла и сверка манифеста.
Главное
Команда verify-safe показывает SAFE, SAFE WITH WARNINGS, UNSAFE или UNKNOWN и отдельно сообщает о находках.
redact --profile share пишет новую копию; исходная трасса остаётся для локальной отладки.
bundle verify сверяет хеши файлов. Это проверка целостности, а не доказательство отсутствия секретов.
В тексте нет команды создания полного demo-pii; нужен fixture из репозитория.
Попробовать за вечер
Возьмите синтетический demo-pii из указанного автором репозитория и запустите npx agent-inspect verify-safe demo-pii --dir .agent-inspect.
Создайте отдельный файл через redact --profile share, затем соберите bundle --out ./evidence и вызовите bundle verify ./evidence.
Метрика: число находок в исходнике и готовом пакете; статус проверки и количество файлов, совпавших с манифестом.
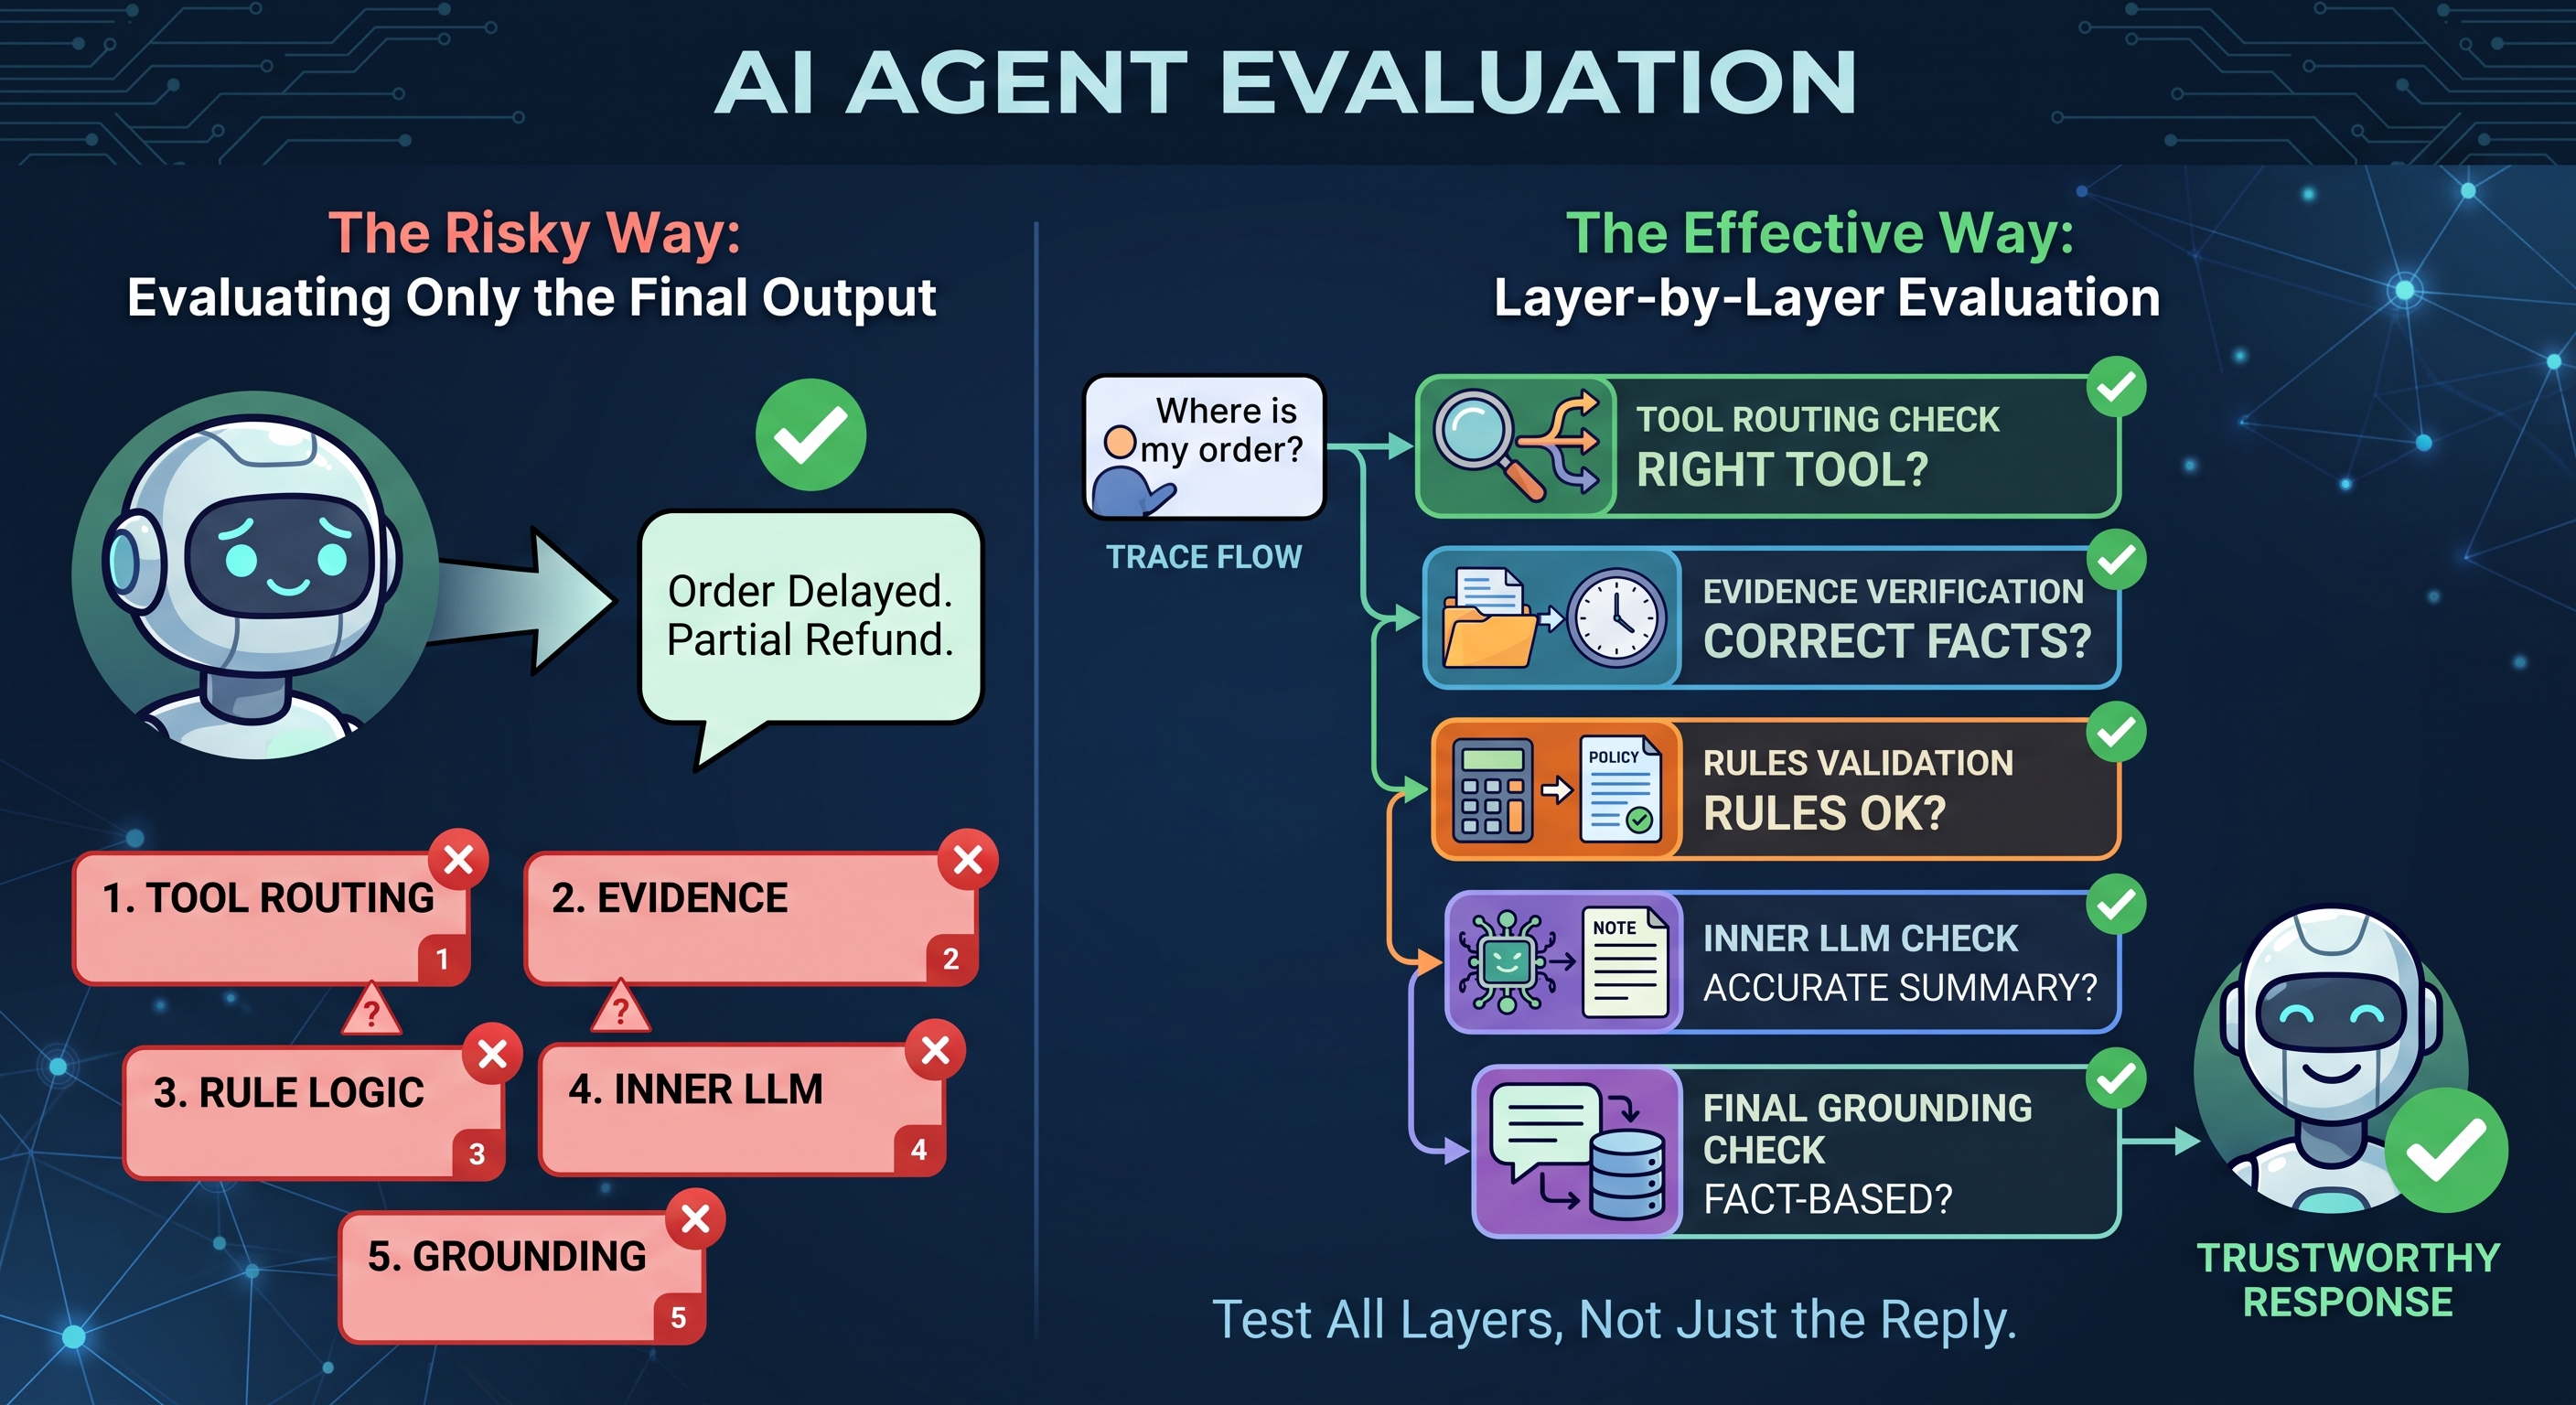
Агент, который вызывает вложенные инструменты, может дать правдоподобный ответ на неверных данных. Статья предлагает разложить один прогон на маршрутизацию, доказательства, правила, внутренний LLM и финальное сообщение.
Главное
В trace сохраняются selected_tool, evidence_ids, recommended_action и claims ответа.
Для каждого слоя задаётся свой эталон: нужный tool, свежесть записи, результат правила и допустимые утверждения.
Пример с доставкой проверяет delay_days=6 и eligibility отдельно от текста ответа.
Приведённый код требует собственных фикстур и функций проверки; таблицы метрик в статье примерные.
Из статьи↗
Схема статьи разделяет оценку агента на маршрутизацию, факты, правила и итоговый ответ.
Попробовать за вечер
Сохраните trace одного существующего агентного сценария с полями selected_tool, evidence_ids, recommended_action и final_response.
Для одного эталонного кейса добавьте assert на каждый слой и запустите его при изменении инструмента или промпта.
Метрика: доля кейсов, в которых найден неверный слой, и число ошибок, скрытых правильным на вид ответом.
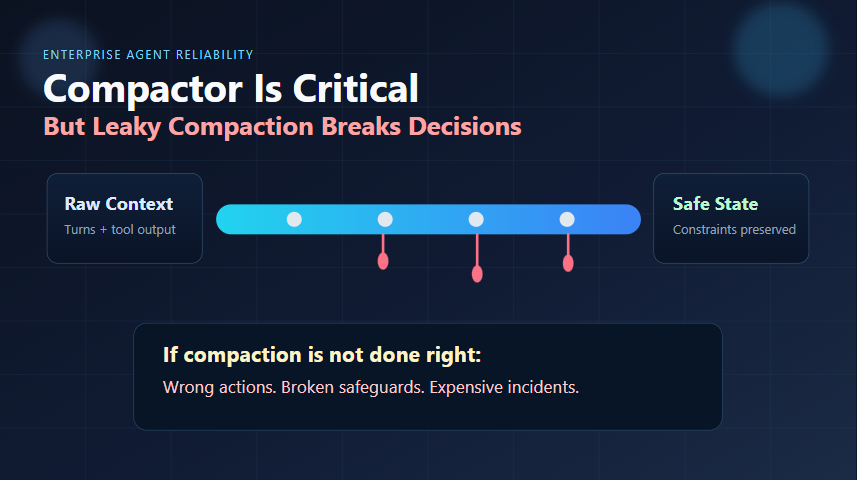
Если агент забывает ограничение после compaction, проблема может быть в сохранённом состоянии, а не в модели. Автор предлагает хранить сущности, запреты, обещания и открытые задачи в типизированных полях.
Главное
TaskState разделяет entities, constraints, commitments, decisions, open_items и risk_flags.
Probe задаёт вопрос к состоянию и ожидаемый ответ; пример проверяет регион us-east-1 и запрет перезапуска БД.
Обычный CI проверяет фиксированные состояния, а отдельный прогон подаёт реальные диалоги в compactor.
Авторские результаты 3/6 и 6/6 получены на небольшом reference benchmark; исходные данные в статье не раскрыты.
Из статьи↗
Авторская схема показывает потерю ограничений при сжатии контекста.
Попробовать за вечер
Составьте TaskState для одного длинного агентного диалога и вынесите жёсткие ограничения в constraints.
Запишите 3–5 probe-вопросов, прогоните текущий compactor и сравните ответы до и после сжатия.
Метрика: сколько probe-вопросов проходит после compaction; перечислите потерянные поля.
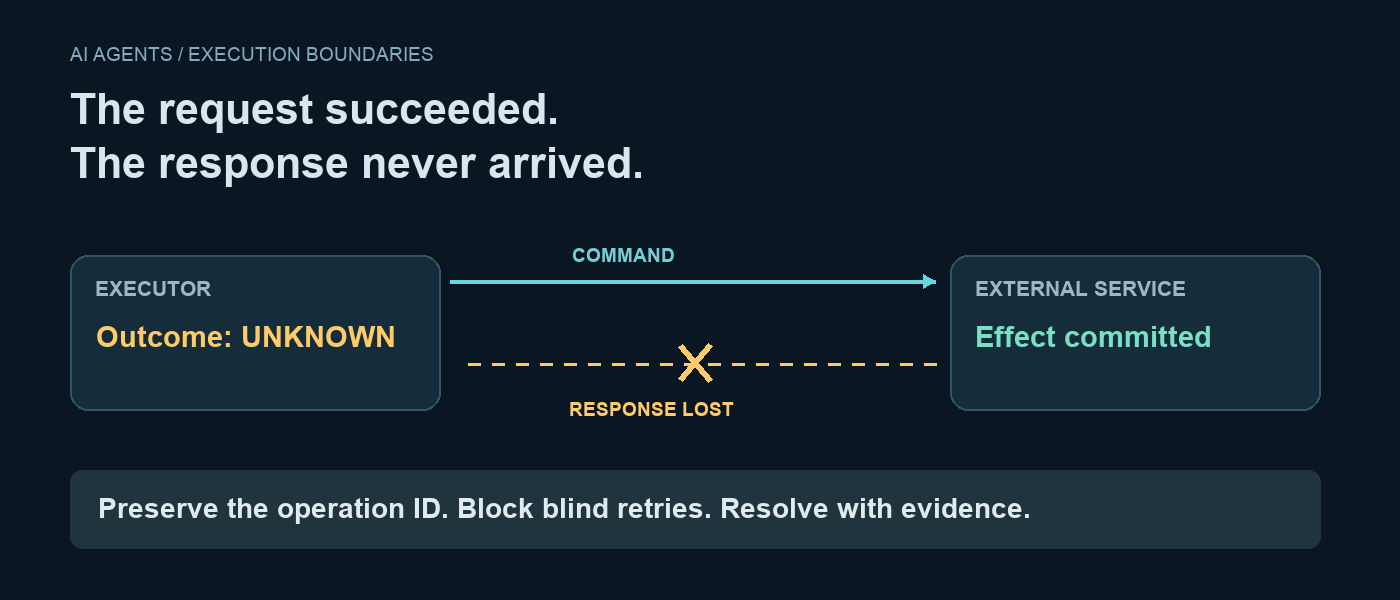
Агент может отправить запрос, получить таймаут и не знать, выполнилась ли операция. Повтор того же действия способен создать дубль. Статья предлагает отдельную устойчивую запись попытки и сверку результата.
Главное
До вызова исполнитель сохраняет fingerprint разрешённого payload и попытку отправки.
После таймаута операция получает состояние UNKNOWN; новая попытка автоматически не создаётся.
Результат закрывается только авторитетной проверкой или ручной передачей оператору.
Это проектный сценарий без результатов испытаний; гарантия однократного выполнения не заявлена.
Из статьи↗
Авторская схема показывает неизвестный исход после потерянного ответа внешнего сервиса.
Попробовать за вечер
Для одного внешнего write API добавьте записи operation, attempt, payload hash и outcome.
Имитируйте таймаут после принятия запроса и проверьте, что система не отправляет attempt-2 до сверки.
Метрика: число повторных отправок при неизвестном исходе и доля UNKNOWN, закрытых проверяемым свидетельством.
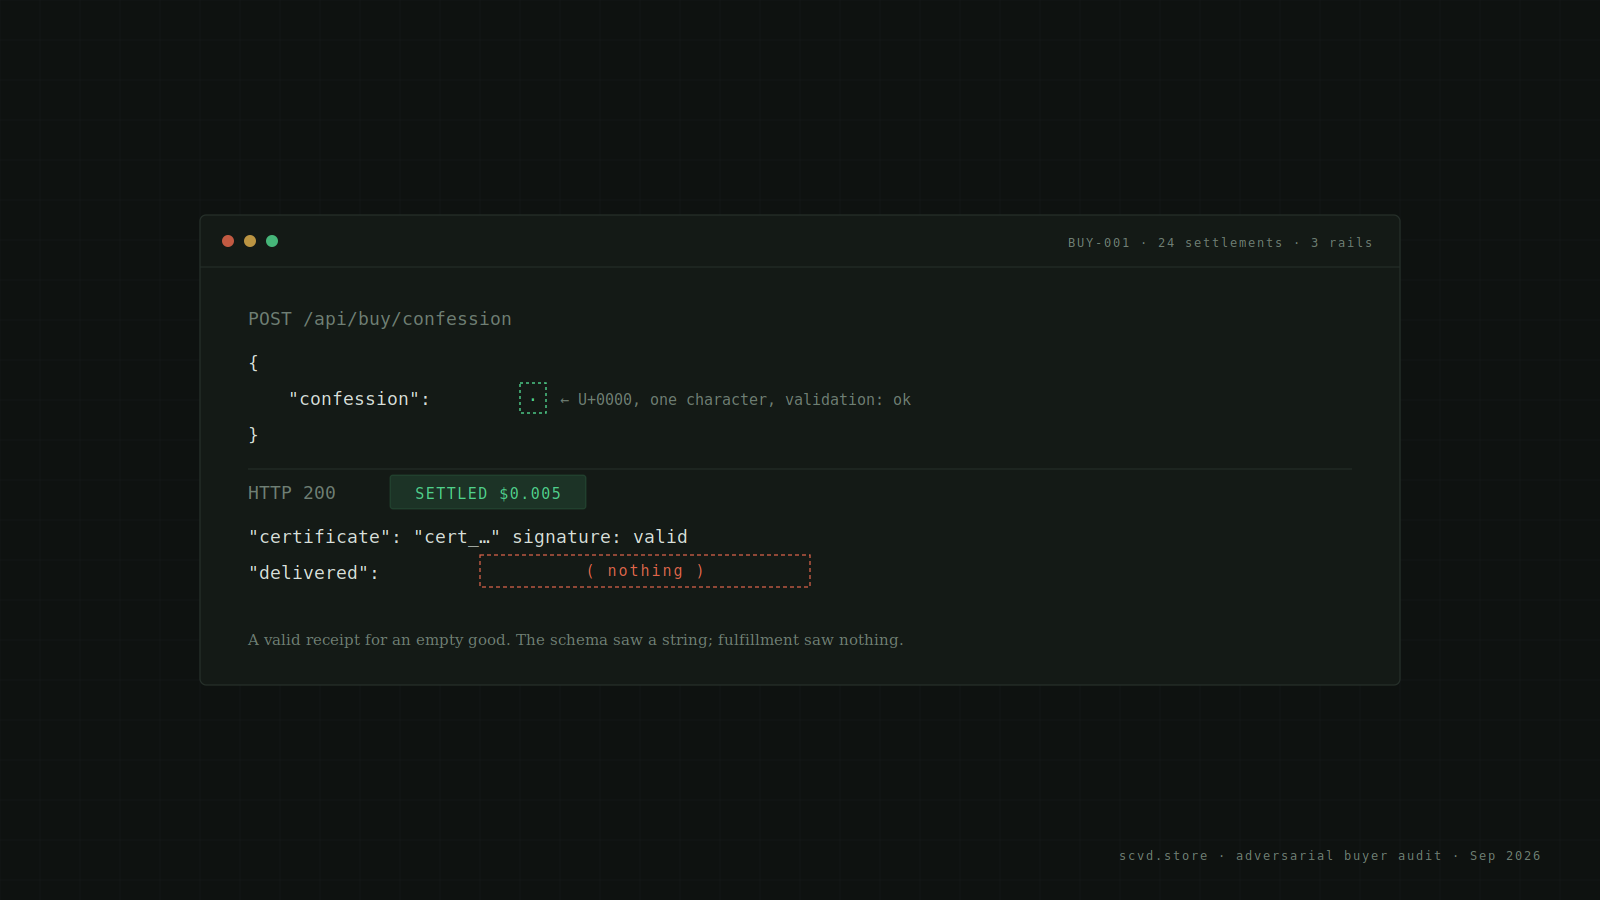
Автор поручил Codex исследовать свой магазин с агентной оплатой и нашёл 39 ошибок вокруг выдачи товара. Подписи и суммы проходили проверку, а сбои возникали после расчёта: при нормализации полей, в ключах кэша и подтверждении заказа.
Главное
Один null byte U+0000 проходил валидацию обязательного текста, но ломал выдачу.
Ключ кэша без claim смешивал результаты разных покупателей.
Проверка проводилась в отдельном worktree с одноразовыми ключами и симулированным settlement.
39 находок относятся к магазину автора; реальные платежи и продакшн-эксплуатация этим тестом не подтверждены.
Из статьи↗
Пример автора показывает успешную оплату и пустую выдачу после значения U+0000.
Попробовать за вечер
Выберите пять дорогих endpoint своего тестового магазина и для каждого проследите путь от подтверждения оплаты до выдачи.
Добавьте случаи U+0000, неверного renewal ID и обрыва ответа после расчёта; сверьте выдачу и возврат денег.
Метрика: число оплаченных сценариев без верной выдачи и число ошибок с воспроизводимыми шагами.
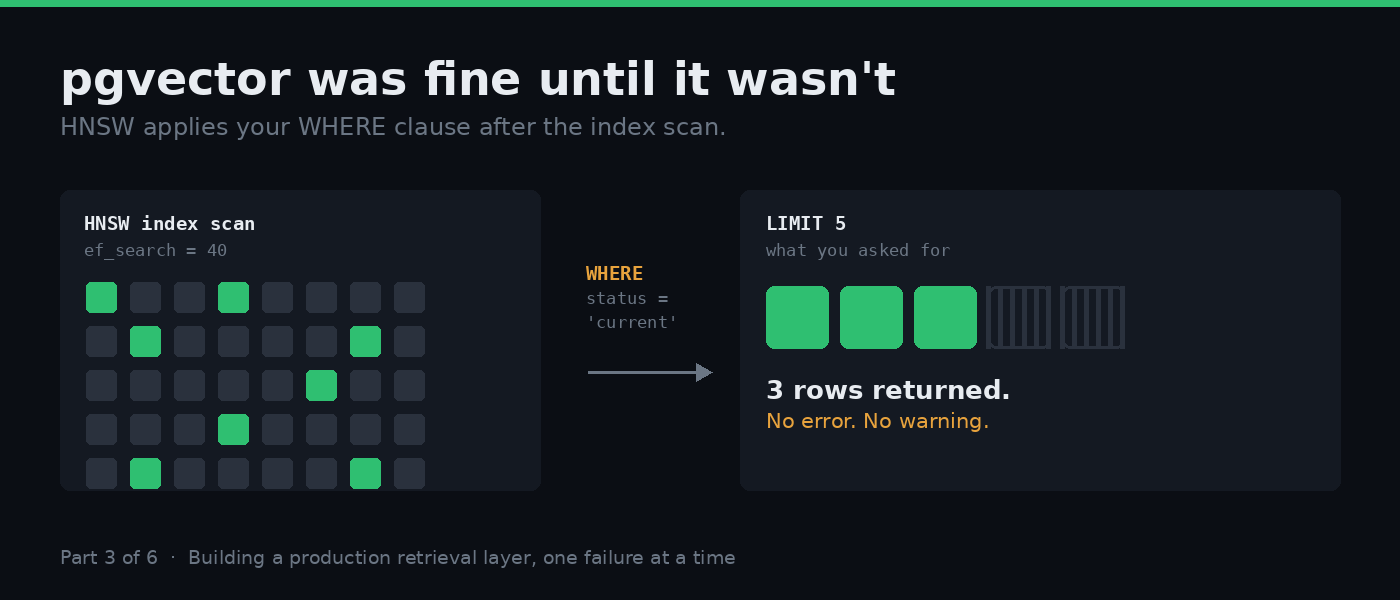
В pgvector HNSW выбирает приближённых кандидатов до фильтрации по статусу или отделу. При узком фильтре запрос может вернуть пустой набор, хотя нужные документы есть в таблице.
Главное
В pgvector 0.8 добавлен iterative_scan: индекс продолжает поиск, пока после фильтра не останется достаточно строк.
Автор показывает relaxed_order, ef_search=100 и max_scan_tuples=20000 как стартовые настройки.
Для постоянного status-фильтра возможен partial HNSW index; текстовый поиск и RRF расширяют набор кандидатов.
HNSW остаётся приближённым поиском; частичный индекс не гарантирует точный recall. В статье нет замеров улучшения.
Из статьи↗
Схема показывает, как фильтр после HNSW оставляет меньше строк, чем запрошено.
Попробовать за вечер
На своей тестовой коллекции запустите прежний запрос с узким фильтром и сохраните найденные document ID.
Включите hnsw.iterative_scan = relaxed_order; повторите поиск и сравните результат с полным перебором для контрольных запросов.
Метрика: recall@k по размеченным вопросам и задержка запроса до и после изменения.
Два агента могут каждый выбрать правильное действие и всё же сломать общий процесс, если одновременно меняют состояние. На примере Google ADK статья показывает fan-out для независимых проверок и JoinNode перед решением.
Главное
Ветви fetch_inventory и evaluate_policy собирают независимые сведения.
JoinNode ждёт оба результата и передаёт их следующему узлу по именам предшественников.
Операции с побочным эффектом идут в последовательном участке графа; порядок проверяется в trace.
Фрагменты ADK не запускаются без собственных функций и настройки; эффект в статье не измерен.
Попробовать за вечер
Нарисуйте граф своего workflow и пометьте узлы, которые только читают данные, и узлы, которые меняют состояние.
Разделите независимые чтения, поставьте join перед решением и проверьте trace при отказе одной ветви.
Метрика: число запрещённых write-действий до join и число запусков с неполными данными на входе решения.
Пустой ответ модели сначала проверьте на лимит вывода
✍ Engin EROLHackerNoonllm-benchmarkopen-source-llms
О чём
В сравнении 27 открытых моделей GLM-5.1 и GLM-5.2 сначала выглядели неисправными. Пять из шести запросов завершались finish_reason=length при max_tokens=500; после повышения до 2500 ответы появились.
Главное
HTTP-успех не означает, что модель закончила содержательный ответ.
Нужно сохранить finish_reason, лимит токенов и видимый текст перед оценкой качества.
Тот же набор запросов следует повторить с большим бюджетом и отдельно сравнить качество и задержку.
Шесть турецких запросов одного провайдера не позволяют обобщить рейтинги моделей.
Попробовать за вечер
Добавьте в журнал бенчмарка finish_reason, max_tokens и длину видимого ответа.
Найдите строки с length и пустым ответом; повторите их с увеличенным бюджетом вывода.
Метрика: число «пустых» ответов из-за лимита и доля запросов, которые дали ответ после повторного прогона.